
昨天的 CI 會自動 build image,並把新 tag 寫回 values-staging.yaml,但部署還要手動 git pull 和 helm upgrade。今天用 ArgoCD 讓 K8s 自己同步 Git 的狀態。
讓 CI 在最後執行 helm upgrade,叫做 Push-based CD。它有幾個問題:
kubectl 改了叢集,Git 裡沒記錄,也沒人知道。Git 是唯一事實來源,叢集主動去 Git 拉狀態,而不是由外部推進來。
Push-based:
CI  →  push  →  K8s Cluster

Pull-based(GitOps):
Git Repo  ←  pull  ←  ArgoCD(在 Cluster 裡面)
                           │
                           ▼
                     同步到 K8s Cluster
方向反過來後,CI 只要能 push 到 Git,不需要碰叢集。
ArgoCD 是跑在叢集裡的 GitOps 工具,持續比對 Git 和叢集的狀態:
Git Repo(期望狀態)
      │
      ▼
ArgoCD 比對差異
      ├── 一致  →  什麼都不做
      └── 不一致  →  自動同步
它可以直接讀 Helm Chart 和 values 檔,Day 24 做好的東西都能沿用。
今天目標:把 staging 交給 ArgoCD 管理,體驗 Auto-sync、Self-heal,最後串起完整的 CI + CD 流程。dev 維持用 Helm 手動管理。
明天的監控要靠 kubelet 內建的 cAdvisor 量測每個容器的 CPU 和記憶體。如果 minikube 的 container runtime 是 Docker,量到的資料會缺少容器名稱,Day 27 的 Grafana 大部分圖表會顯示 No data。runtime 只能在建立叢集時決定,趁 ArgoCD 還沒裝,先確認一下:
kubectl get nodes -o wide
看最右邊的 CONTAINER-RUNTIME 欄位:
containerd://...:沒問題,直接跳到 Step1。docker://...:照下面的步驟重建叢集。為什麼 Docker 不行?K8s 1.24 移除 dockershim 後,Docker 要透過 cri-dockerd 接上 K8s,kubelet 的 cAdvisor 就查不到容器資訊,量得到用量卻對不回是哪個容器。詳細原因 Day 27 會再說明。
重建會清空叢集裡的所有東西,但 Chart、values 檔和 CI 設定都在 Git 上,不受影響。現在叢集裡只有 Day 24 的 dev 和 staging,是重建成本最低的時候;等 ArgoCD 裝好再重建,repo 設定和 Application 都要重做。
1. 刪除叢集,改用 containerd 重建
minikube delete
minikube start --container-runtime=containerd --memory=8192 --cpus=4
接下來會同時跑 dev、staging、ArgoCD 和監控,記憶體建議至少 8 GB,
--memory、--cpus依電腦調整。
2. 確認 runtime 已經是 containerd
kubectl get nodes -o wide
CONTAINER-RUNTIME 要顯示 containerd://...。
3. 重新啟用 addon
Ingress Controller 和 metrics-server 也跟著叢集刪掉了,HPA 和 Ingress 都需要它們:
minikube addons enable ingress
minikube addons enable metrics-server
4. 重新部署 dev
在 helm/ 執行,跟 Day 24 Step4 相同:
helm install todo-dev ./todo-app \
  -f values-dev.yaml \
  --set mysql.password=devpass123 \
  --set mysql.rootPassword=devroot123 \
  -n dev --create-namespace
PowerShell 換行要把
\改成反引號`,或寫成一行。
5. staging 不用重裝
Step3 本來就要移除 Helm 管理的 staging,交給 ArgoCD。重建後的叢集沒有 staging,直接跳過 Step3,Step4 的 Application 會連同 namespace 一起建立。MySQL 是全新的,不會有舊資料。
6. 確認環境
kubectl get pods -n dev
kubectl get pods -n ingress-nginx
kubectl top nodes
dev 的 Pod 都 Running、kubectl top nodes 有數字,就可以繼續 Step1。
⚠️ Pod 卡在拉 image 時:新叢集要重新下載所有 image,網路環境不同,某些 registry 可能拉得很慢或拉不下來,Pod 會卡在
ContainerCreating或ImagePullBackOff。可以先在本機拉好,再載入 minikube:# 查出卡住的 Pod 用的 image kubectl describe pod <Pod 名稱> -n <namespace> # 在本機拉取,再載入 minikube docker pull <image 名稱> minikube image load <image 名稱> # 刪掉卡住的 Pod,讓它用已載入的 image 重建 kubectl delete pod <Pod 名稱> -n <namespace>
kubectl create namespace argocd
kubectl apply -n argocd --server-side --force-conflicts \
  -f https://raw.githubusercontent.com/argoproj/argo-cd/stable/manifests/install.yaml
不加
--server-side可能會出現metadata.annotations: Too long,因為 ArgoCD 有些 CRD 太大。
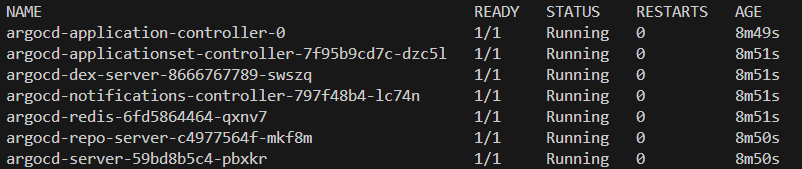
等 Pod 都 Running:
kubectl get pods -n argocd
kubectl port-forward svc/argocd-server -n argocd 8443:443
kubectl -n argocd get secret argocd-initial-admin-secret -o jsonpath="{.data.password}" | base64 -d
PowerShell:
$pw = kubectl -n argocd get secret argocd-initial-admin-secret -o jsonpath="{.data.password}"
[Text.Encoding]::UTF8.GetString([Convert]::FromBase64String($pw))
https://localhost:8443,帳號 admin,密碼是上面的輸出。瀏覽器出現憑證警告是正常的(自簽憑證),選擇繼續前往即可。
staging 現在是 Helm 的 Release,接下來要交給 ArgoCD。同一份資源不要讓兩個工具同時管,先移除:
helm uninstall todo-staging -n staging
MySQL 的 PVC 不會被刪掉,資料會保留。下一步要用跟 Day 24 相同的密碼,才連得上原本的資料。
在 helm/ 建立 argocd-staging.yaml:
apiVersion: argoproj.io/v1alpha1
kind: Application
metadata:
  name: todo-staging
  namespace: argocd
spec:
  project: default
  source:
    repoURL: https://github.com/yourname/Todo-App
    targetRevision: main
    path: helm/todo-app
    helm:
      releaseName: todo-staging
      valueFiles:
        - ../values-staging.yaml
      parameters:
        - name: mysql.password
          value: Stg8xK2mQ9pL
        - name: mysql.rootPassword
          value: StgRoot7vN3wR5
  destination:
    server: https://kubernetes.default.svc
    namespace: staging
  syncPolicy:
    automated:
      prune: true      # Git 裡刪掉的資源,叢集也刪除
      selfHeal: true   # 叢集被手動改動,自動還原成 Git 的狀態
repoURL:換成你的 repo。private repo 要先在 ArgoCD UI 的 Settings → Repositories 加入存取權限。releaseName:維持 todo-staging,資源名稱才會跟之前一樣。valueFiles:路徑相對於 path,values-staging.yaml 在上一層,所以是 ../。parameters:等同 helm install 的 --set,傳入密碼。⚠️ 這個檔案有密碼,不要 commit,加進
.gitignore。正式環境會用 Sealed Secrets 或 External Secrets 管理密碼,這裡先簡化。
kubectl apply -f argocd-staging.yaml
ArgoCD UI 會出現 todo-staging,狀態是:
點進去可以看到 Deployment、Service、Pod 等所有資源。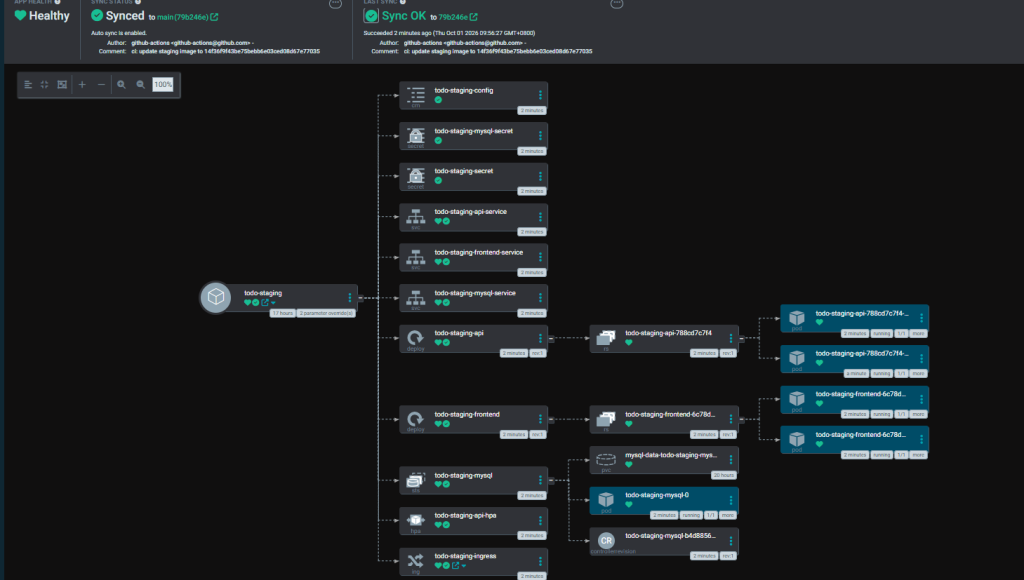
也可以用指令確認:
kubectl get pods -n staging
helm list -n staging
Pod 都回來了,但 helm list 是空的,staging 現在由 ArgoCD 管理,之後不要再對它下 helm upgrade。
把 values-staging.yaml 的 frontend.replicas 從 2 改成 3,push 上去:
git pull
git commit -am "scale staging frontend to 3"
git push
用 frontend 而不是 API,因為 staging 的 API 由 HPA 控制,改
api.replicas不會生效。
ArgoCD 預設約 3 分鐘檢查一次 Git,等不及可以在 UI 按 Refresh。同步後:
kubectl get pods -n staging
frontend 變成 3 個,全程沒有下任何部署指令。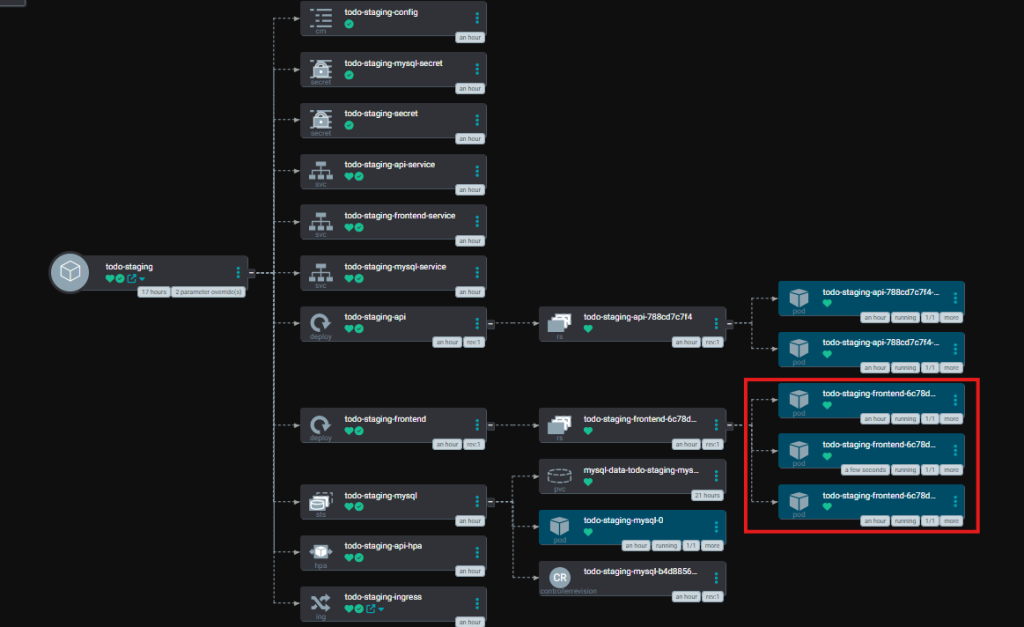
只改
helm/不會觸發 CI,因為昨天設了paths-ignore。
Step 4 設定了 selfHeal: true,ArgoCD 會持續比對叢集和 Git,發現不一致就自動還原成 Git 的狀態。來試試看手動改叢集會發生什麼事。
另開一個終端機,先持續觀察 Pod:
kubectl get pods -n staging -w
在原本的終端機把 frontend 改成 1 個:
kubectl scale deployment todo-staging-frontend -n staging --replicas=1
觀察的終端機會看到:
todo-staging-frontend-6c78d45bc5-cvssf   1/1     Terminating         0          21m
todo-staging-frontend-6c78d45bc5-8v7nj   1/1     Terminating         0          21m
todo-staging-frontend-6c78d45bc5-6xz6t   0/1     Pending             0          0s
todo-staging-frontend-6c78d45bc5-2s6sl   0/1     Pending             0          0s
todo-staging-frontend-6c78d45bc5-6xz6t   1/1     Running             0          2s
todo-staging-frontend-6c78d45bc5-2s6sl   1/1     Running             0          2s
kubectl scale 把 Deployment 改成 1 個,兩個 Pod 被刪除;ArgoCD 發現跟 Git 的 replicas: 3 不一致,把 Deployment 改回 3 個,K8s 就補上兩個新 Pod,前後約 2 秒。
這就是開頭提到的漂移問題:有人繞過 Git 直接改叢集,ArgoCD 會把它還原。想改設定,就只能改 Git。
還原速度很快,如果沒先開觀察就直接
kubectl get pods,可能只看到 3 個 Pod,其中兩個的 AGE 只有幾秒,代表它們剛被重新建立。
觀察完到觀察的終端機按 Ctrl + C 結束。
改一點程式碼(例如 API 回應的文字),push 上去:
git pull
git commit -am "update api message"
git push
Push 程式碼
    │
    ▼
GitHub Actions CI
├── build、push image(tag = commit SHA)
└── 更新 values-staging.yaml 的 tag,commit 回 Git
    │
    ▼
ArgoCD 偵測到 Git 變更
    │
    ▼
自動部署到 staging
CI 跑完後等 ArgoCD 同步(或按 Refresh),確認 image 是新的 commit SHA:
kubectl get deployment todo-staging-api -n staging -o jsonpath="{.spec.template.spec.containers[0].image}"
要 rollback,就
git revertCI 那筆 commit 再 push,ArgoCD 會同步回舊版本。Git 的歷史就是部署的歷史。
練習結束後,到 Step2 的終端機按 Ctrl + C 停掉 port-forward。
git revert
明天會學監控,用 Prometheus + Grafana 讓叢集的狀態可視化 !


 iThome鐵人賽
 看影片追技術